Cryptojacking: la minería de cryptomonedas como modelo de negocio

Estoy seguro de que muchos habéis pensado en usar el cryptojacking como modelo de negocio –las ideas suelen surgir simultáneamente en muchas cabezas a la vez- cuando hayáis visto noticias sobre cryptojacking, como el sonado caso de la CBS que durante un fin de semana tuvo incluido en su reproductor un script para minar cryptomonedas. ¿Pero es realmente factible? Entendámoslo y observemos sus implicaciones.

web coin photo
Photo by SMU Central University Libraries

El cryptojacking es un concepto más o menos novedoso, que se refiere a realizar minería de cryptomonedas usando para el computo los navegadores de visitantes a una web. Normalmente se supone poco ético, pero vayamos por partes que hay muchos conceptos:

  • Recordaréis cuando hablamos de blockchain, a las personas que se dedican a calcular los hash de los bloques se les llama mineros, porque el algoritmo les otorga una pequeña cantidad de cryptomoneda a quienes encuentran cada hash.
  • Para realizar esa minería, para buscar esos hash hay que realizar muchos cálculos invirtiendo en tiempo de procesador. Hay empresas que se dedican a la minería y que tienen montones de ordenadores (granjas) dedicados a realizar estos cálculos.
  • Una web, es una aplicación distribuida en la que parte del programa se ejecuta en el servidor, y otra parte se ejecuta en el navegador de los usuarios.
  • Cuando se usa la capacidad de computación de los visitantes a una web, para realizar minería, es cuando estamos hablando de cryptojacking.

En casi todos los casos en los que se habla de cryptojacking se trata (o al menos se supone) de webs que han sido crackeadas, en las que se ha incluido el código necesario para realizar la minería, pero ¿y si no siempre fuese así? ¿Y si una web de manera legítima implementara este sistema de minería para financiarse? ¿Qué podría pasar?

Esta técnica hace que se consuman recursos de los equipos de los visitantes, pero por norma general, la mayoría de los visitantes tienen recursos más que sobrados en sus sistemas que están muy infrautilizados. Al final es como los sistemas para compartir potencia para cálculos distribuidos, ya sea para encontrar una cura para el cancer o buscar vida fuera de nuestro planeta. Los usuarios le estarían cediendo sus recursos a una web durante el tiempo que se pasen consumiendo sus contenidos.

Si esto se usase como sustitutivo de los anuncios (que cada vez funcionan menos y peor en la web actual), no les supondría una gran carga adicional a los usuarios, puesto que los anuncios por si mismos ya están consumiendo recursos de sus máquinas. Además dejarían de estorbar visualmente.

También, se implementarían las webs para que tuviesen la menor cantidad de recargas, y para que se pase el mayor tiempo posible con ella abierta. Por ejemplo, en una web de noticias, esto es posible que provocase que se empezaría a dejar de lado el clickbait y empezar a crear contenidos realmente relevantes e interesantes.

Para saber si es algo rentable, tendríamos que tener en cuenta muchos factores, principalmente el valor puntual de la cryptomoneda que se esté empleando. También de cuanta cantidad de cryptomoneda se  lleva el minero que tenga éxito en encontrar el hash de un bloque. Por último, cuanto tiempo medio de visitante en la página se necesita para encontrar un hash. Podríamos meter más variables como el coste de adquisición de un usuario, lo que se deje de ingresar por publicidad o muchas otras cosas, pero sólo con estas tres variables ya se ve que hay que centrarse en un caso particular para determinar si es rentable o no.

Por ejemplo, cada vez que se encuentra un hash de un bloque de Bitcoin, el minero se lleva 12.5 Bitcoins (aunque se dividirá por dos en el futuro). El precio de los Bitcoin es muy variable, pero hace ya días que está por encima de los $5,500. Por tanto, estamos hablando de más de $70,000. Por ejemplo, atendiendo a las cuentas públicas de un medio que conozco bien, les bastaría con conseguir minar un hash a la semana para ser rentables y olvidarse de la guerra de la publicidad.

Lo difícil es saber como de factible es que un sistema distribuido como este consiga minar uno de estos hash, pero desgraciadamente de eso no hay muchos datos y tendremos que esperar a que algún medio con suficiente calado se anime a hacer pruebas legítimas y en condiciones, y que posteriormente se animen a compartir esa información.

¿Cómo lo veis como usuarios? ¿Os preocuparía que se usase vuestro equipo para esto si a cambio os libraseis de la fastidiosa publicidad?

Machine Learning fácil fácil

Dentro de esa serie de posts en los que explicamos de un modo muy asequible cosas tan abstractas como los hash, los blockchains o incluso la economía colaborativa, llega el momento de hablar de algo que a la mayoría le parece super futurista y abstracto, pero que en realidad es fácil fácil: el machine learning.

El objetivo principal de machine learning (aprendizaje automático) es que las máquinas aprendan para tomar decisiones. En concreto, su aplicación suele centrarse en que dado un nuevo elemento, un programa de ordenador decida si está en una categoría de un grupo de categorías dado.

highway toll photo
Photo by Dougtone

Vamos a ejemplificarlo con un caso que pudiera ser real: resulta que el gobierno decide que para volver a hacer las autopistas rentables, va a cambiar su modelo. Quitará el límite de velocidad, y los conductores pagarán en función de la velocidad a la que transiten. Para las que se pagan a posteriori no tienen problema y lo implementan en un par de meses, pero las que se pagan por anticipado son un problema y aunque ven que es un modelo que funciona, no lo pueden aplicar ya que no pueden cambiar todas las cabinas de peaje al otro extremo de los tramos.

Un investigador de una universidad se percata casi por accidente de que la gente que más rápido transita utiliza ciertas marcas de automóvil influenciados por los tramos y las horas del día. No es en el 100% de los casos, pero si se cumple en un porcentaje suficientemente alto como para decidir que se puede cobrar en el peaje un fijo en función de la marca del coche que se tenga.

Para esto se tomarían un montón de fotos de radares, cámaras y demás dispositivos de vigilancia y si clasificarían en función de la marca del coche que aparece en ellas. Cuanto más grande sea la muestra inicial mucho mejor, pero pasa como con las muestras de encuestas de población: con ¿650? personas con determinada distribución, se puede predecir el comportamiento de todo Cantabria, y tener 1000 personas no hace que se acierte mucho más, tal vez se afine un 0.01% adicional que no resulta sustancial.

De estas fotos agrupadas en categorías, se seleccionan ciertas propiedades que sean diferenciales. Estas pueden ser muy variadas, por ejemplo puede ser la disposición de los pixeles del centro de la foto en una conversión a grises, puede ser las coordenadas de la cabina de peaje dónde se tomo, la hora, el número de pixeles que hay entre las ruedas, … cualquier información que se tenga puede ser útil, pero no toda la información lo es. Por eso hay que trabajar con esas propiedades para reducirlas al mínimo necesario a tratar para tomar una decisión acertada. Por ejemplo, se puede llegar a la conclusión de que la distribución de pixeles del centro de la foto aporta exactamente lo mismo que los pixeles que hay entre las ruedas, por lo que no tiene sentido tratar ambas propiedades y es mejor gastar energías en determinar el valor de una sola de ellas.

Cuando ya se han encontrado las propiedades adecuadas, se plantea una formula, el modelo: un algoritmo sencillo que dada una nueva imagen nos vaya a determinar en que categoría hay que incluirla. Esta puede ser algo tan sencillo como:

ax+by+cz

siendo a, b, y c constantes que hemos determinado en nuestros procesos previos, x el color predominante en la foto, y un valor valor que representa la distribución de pixeles centrales de la foto y z la hora en la que se tomó la foto.

El valor de esta formula nos dirá que de 0 a 0.2 son los coches de marcas cuyos propietarios suelen ir despacio, de 0.2 a 0.6 son los que suelen ir a la velocidad marcada por la vía, y de 0.6 a 1 los que suelen ir por encima de la velocidad recomendada.

Por tanto, una vez obtenida esta fórmula, ya se pueden procesar las fotos tomadas en las cabinas de telepeaje, de tal modo que se determine instantáneamente si un conductor debe pagar 2, 5 o 10 euros.

Esto tan sencillo es machine learning: encontrar ese modelo que se puede aplicar de un modo automático para tomar decisiones. Fácil ¿no?

Una vez entendido esto podemos entrar en la distinción entre aprendizaje supervisado o no supervisado, deep learning y otras cosas; pero estas son otras historias que tendrán que ser contadas en otro momento.

Blockchain fácil fácil

Ya son varias las personas de distinto ámbito que me han pedido una explicación sencilla de lo que es Blockchain, así que supongo que es un tema que debo plasmar aquí, y dejar de contarlo entre cervezas. Voy a intentar que cualquier persona con una base técnica mínima pueda entenderlo, pero ante las dudas preguntad en los comentarios 😉

blockchain photo
Photo by btckeychain ©

Blockchain, como su propio nombre indica, es una cadena de bloques. En cada bloque se almacena una información y el hash del bloque anterior (¿os acordáis de la explicación sobre lo que es un hash de la semana pasada?).

De este modo, al almacenar cada bloque la «firma» del anterior, si se cambiase el contenido de un bloque se alteraría esa firma, con lo que habría que cambiar el contenido del siguiente bloque, y así sucesivamente hasta llegar al bloque más actual.

Eso, así de simple es un blockchain.

Ahora bien, seguro que habéis oído que este sistema se está usando en criptomonedas y en otras soluciones porque se supone que no se puede alterar los bloques ¿no?

En un blockchain que se almacenase en un solo lugar sería «trivial» alterar el contenido de un bloque random. Sin embargo, todos los sistemas que se están basando en esto son sistemas distribuidos, en los que hay muchos participantes que mantienen una copia de toda la cadena de bloques, por lo que para poder alterarla sin que todo el mundo se de cuenta, no sólo habría que modificar todos los bloques que maneje una máquina, si no que habría que hacerlo en todas las máquinas que almacenan una copia.

Vamos a poner un ejemplo práctico aplicado a algo que muchos habréis sufrido:

  • Imaginemos que tenemos un cuaderno en el que vamos a apuntar el acta de las reuniones de una comunidad de vecinos.
  • Para que no haya alteraciones, decidiremos que cada página tiene que empezar siempre con el «hash» de la página anterior.
  • El hash en este caso (para que sea fácil de calcular a mano), estará formado por la primera y última letra de cada fila y entre ambas el número de caracteres.
  • De este modo, si cambiásemos una página cambiaríamos su hash, que al ser la primera línea de la página siguiente, nos provocaría también cambiar su hash, etc. etc.
  • Un presidente maquiavélico podría comprarse un nuevo cuaderno para cambiar todas las actas y plasmar que a él se le eligió de por vida. Pero, si todos los propietarios tuviesen una copia del cuaderno, el presidente no podría hacerlo a no ser que pudiese entrar en todas las casas de todos los vecinos a pegar el cambiazo por un cuaderno modificado.

¿Queda claro?

Las aplicaciones de esto pueden ser muchas, aunque generalmente se usa para crear soluciones que eliminen intermediarios.

Por ejemplo, es la base de Bitcoin, la primera criptomoneda que se creo para poder hacer micropagos. El problema de los micropagos, era que al tener a los bancos como entidades intermediarias, las comisiones hacían imposible realizar estos micropagos. Al eliminar los intermediarios, los pagos pueden ser gratuitos, y hacerlos tan pequeños como se quiera.

Esa es la teoría, porque Bitcoin se ha expandido mucho por otros motivos derivados de la eliminación de intermediarios (anonimato, capacidad de especulación desmesurada, acceso universal, …), pero eso ya es otra historia que tendrá que ser contada en otro momento.

Explicación fácil de lo que es un «hash»

Si nos pusiéramos muy técnicos tendríamos que hablar de qué y cómo son las funciones hash, pero no es el día. Saber que son los hash es necesario si queremos hablar de Blockchain, de BigData, y de muchas otras moderneces con propiedad. Pero no es necesario entrar en detalles ni ponerse muy técnico para entender lo que son y como se usan. Vamos pues.

byte photo

Aquí ya hablamos de las tablas Hash, que son un patrón de diseño de sistemas distribuidos. Pero más allá de eso se usan en montones de estructuras de datos, de algoritmos y demás.

El hash es como se llama coloquialmente al resultado de una función hash, y estas son funciones que se encargan de transformar un conjunto de datos en una simple cadena de texto. Digamos que el hash es como una firma que resume a todo un conjunto de datos.

Por ejemplo, imaginemos que yo tengo un boli Bic azul comprado ayer mismo. Su hash podría ser (por ejemplo, el proporcionado por una función recién ejecutada en mi mente) BBA20170703005301058. Si aplicásemos la misma función a cualquier otro boli nos daría un valor distinto y si se la volviésemos a aplicar a ese mismo boli nos volvería a dar este valor.

¿Y esto para que sirve? Por ejemplo, si algún malvado villano me escondiese mi boli entre un millón de otros bolis similares (todos Bic azul), sólo tendría que aplicar esta función a cada boli hasta encontrar el que tiene esa firma para saber que es el mío. Otra función sería, si castigásemos a nuestro villano favorito a ordenar todos los bolis en un gran almacen, este podría ir apuntando la firma de cada boli con la estantería en la que lo guarda para luego poder encontrarlos de un modo rápido y fácil.

Estas, a bote pronto, son las funciones principales que se me ocurren (demostrar autenticidad y conseguir indexación), pero es muy posible que se usen estos códigos en muchos otros ámbitos que a mi ahora no me vienen a la cabeza. ¿Tenéis vosotros en mente otros ejemplos?

Lo normal, es que este tipo de funciones tengan en cuenta todo el conjunto de datos, o todas las características del objeto sobre el que se aplica, de tal modo que si el villano hubiese sido tan perverso de cambiar el capuchón de mi boli por el de otro, habría conseguido vencerme, pues la función hash que yo había ideado ya no proporcionaría el mismo valor.

Depende de para que se use, podemos encontrarnos con problemas, ya que puede ocurrir que haya colisiones y que, por una alineación de los astros, para dos objetos distintos se obtenga el mismo hash.

Sin embargo, a pesar de esas posibles colisiones, al ser (normalmente) el resultado de un algoritmo de compresión con pérdida, de un hash no se puede obtener el objeto original invirtiendo la función, así que será muy difícil encontrar para un hash un objeto o conjunto de datos válido que pueda sustituir al original como auténtico sin serlo. Esta es la clave, por ejemplo, de su uso dentro de los blockchains, pero eso ya es otra historia que deberá ser contada en otro momento.

How to implement a distributed OAuth 2.0 system

Some months ago (more than a year), I was playing with the WordPress REST API. I did an analysis about how to implement a distributed OAuth 2.0 system as an attempt to collaborate with the community. I wrote it as a comment over a discussion post, but I am going to replicate that here in order to save it with my other ideas and works.

  • coolapp.com is the site of the app
  • cooldev.com is the WP site of the developer in which I defined the app as multitenant
  • cooluser.wordpress.com is the WP site of the user who wants authorize coolapp.com to interact

01- User access to coolapp.com and says “Hey, I want to use this cool app”
02- coolapp.com ask for its server and user writes cooluser.wordpress.com
03- coolapp.com ask to cooluser.wordpress.com to identify the user
04- the user writes his credentials in cooluser.wordpress.com
05- cooluser.wordpress.com redirects to coolapp.com with a code saying “Yeah, this man is my man”
06- coolapp.com then ask to cooldev.com and says “Hey, I have a user with a code that wants to acces to the resource cooluser.wordpress.com and I am the coolapp.com (this is my client_id and this my client_secret)”
07- cooldev.com generates a token
08- cooldev.com says to cooluser.wordpress.com “Hey, I just generated this token that expires in 3600 seconds”
09- cooluser.wordpress.com says “I would prefer not to work, but you know, it’s ok”
10- cooldev.com sends the response to coolapp.com with the token
11- then coolapp.com using the token, can now ask to cooluser.wordpress.com to do some stuff

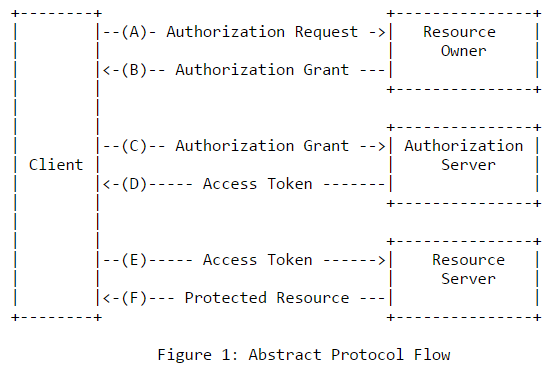
If you look at this diagram

Abstract Protocol Flow

Client = coolapp.com
Resource Owner = cooluser.wordpress.com
Authorization Server = cooldev.com
Resource Server = cooluser.wordpress.com

The RFC says:

“The interaction between the authorization server and resource server
is beyond the scope of this specification. The authorization server
may be the same server as the resource server or a separate entity.
A single authorization server may issue access tokens accepted by
multiple resource servers.”

but with some conversation like the one in 8 and 9 it could be resolved.

Azure Serverless

No, no es una nueva feature de Azure de la que no te hayas enterado. En este artículo vamos a entender que es «serverless» ese concepto tan en boca de todos, y los componentes de Azure que se pueden considerar parte de esta moda.

Seguir leyendo en CompartiMOSS.

De .Net Core, Webjobs y despliegue automático

En otras ocasiones hemos hablado de .Net Core, de los webjobs y aunque nunca he escrito mucho sobre ello tengo interés por automatizarlo todo lo más posible. Para esto último, intentando no sobretrabajar he usado siempre las funcionalidades de Visual Studio Team Services.

El problema que voy a describir, es un problema con una solución tremendamente sencilla una vez que das con ella, pero que al no haber ningún tipo de documentación y no haber nadie por el mundo que haya hecho exactamente eso y lo haya contado, acabas teniendo que ir deduciendo cosas, poniendo parches y testeando multiples variantes hasta que das con el conjunto de pasos buenos que te salvan la vida.

Como sabéis .Net Core ha roto el cascarón de su primera versión hace muy poquito, y aunque mola mucho porque es muy ligero, es multiplataforma, te facilita (o fuerza) a usar ciertos patrones que merecen la pena… A pesar de todas esas cosas también tiene sus pegas, y las principales creo que son sin ninguna duda el tooling y las librerías que permiten la integración con otras partes del entramado Microsoft.

Del mismo modo, el SDK de los webjobs también es relativamente nuevo, y tiene muy pocas funciones y sólo vale para el Framework de .Net (el de toda la vida).

El tercer componente de nuestra ecuación es el más maduro, ya que Visual Studio Team Services viene de TFS que lleva ya dando vueltas mucho tiempo y tiene multiples opciones con las que solventar las cosas cuando no hay un componente específico (a las malas siempre puedes subir tu propio script de PowerShell por ejemplo).

El problema de juntar estos tres elementos es que no hay SDK de webjobs para .Net Core, y que las herramientas de core no permiten añadir un webjob a tu proyecto.

Las estrategias posibles para afrontar este problema son múltiples:

  • Despliegues independientes. Siempre puedes montar despliegues independientes, pero tendrás que gestionar todo por separado y no en todos casos va a ser lo ideal. No tiene porque suponer un incremento en costes porque lo puedes tener rulando todo en el mismo Service Plan para que compartan recursos y esperar a que todo crezca mucho para separa cada cosa por su lado en ejecución. Sin embargo, a mi personalmente, me deja mal sabor de boca el hacer algo forzado porque no sé, cuando en el caso que teníamos entre manos el ideal era llevarlo junto ya que hay cierta dependencia entre proyectos.
  • Montar el webjob con .Net Core sin el SDK. Al final un webjob no deja de ser un programa o script que ejecutas. Puedes montar un ejecutable independiente o una dll que invocarás con el comando dotnet y las librerías de .Net Core para acceder al storage de Azure y hacerte tu propio acceso a datos y tus disparadores y esas cosas. Esto… es una opción pero multiplica el tiempo de desarrollo de cada webjob al menos por tres, te hace picar mucho más código y asumir más responsabilidades de las que deberías. Sí que es cierto que el rendimiento mejoraría, así que puede ser la opción buena en función de lo intensivo que vaya a ser el webjob. En nuestro caso el webjob necesitaba usar unas librerías que sólo existen en .Net Framework y por tanto no era una opción que pudiésemos tomar sin desarrollar un montón de componentes para .Net Core.
  • Hacer tu webapp con .Net Framework. Siempre es una opción, pero la diferencia de rendimiento creo que justifica suficientemente el no tomar esta opción por defecto nunca.
  • Hacer que las dos tecnologías se entiendan y todos los despliegues funcionen bien. Generalmente todo es posible, y aunque no hubiese documentación al respecto, siempre podríamos haber hecho scripts propios e intentar que se lanzasen cuando tocase (que en una pequeña parte es lo que hemos hecho). Aunque llegar al conjunto de pasos más simple posible para no condenar a tu yo del futuro puede llegar a ser complicado. Esta ha sido la opción que tomé para ponerlo todo a andar.

Lo primero de todo es hacer que cuando publicas desde tu Visual Studio a maneja a Azure para hacer alguna prueba puntual montando una nueva webapp se despliegue con ella el webjob para que no haya problemas y todo funcione correctamente.

Para hacer esto solo hay que seguir unos muy muy simples pasos, y aunque todos tienen su lógica y explicación, voy a pasar muy rápido por ellos para no enrollarme:

  1. Lo primero es crearte en tu proyecto de aplicación web una carpeta app_data si no la tienes ya. En ella tendrás que crear otra que se llame jobs y dentro de esta tienes que actuar en función del tipo de webjob que tengas:
    1. Si es un webjob que se ejecuta continuamente esperando a que salte algún trigger desde el storage, tendrás que crear una carpeta que se llame Continuous.
    2. Si el webjob es de ejecución manual y lo vas a lanzar tú cuando te convenga (¿por qué nadie querría hacer esto?), tendrás que crear una carpeta que se llame Triggered.
    3. Si el webjob es de ejecución programada o agendada (scheduled, vamos), tendrás que crear también una carpeta que se llame Triggered, pero posteriormente deberás dar un paso adicional.
  2. En esa carpeta (o carpetas si tienes distintos tipos de webjobs), deberás crear una carpeta por cada webjob con el nombre que quieras ver en Kudu.
  3. En esa carpeta tienes que meter un script que se llame run.cmd (hay otras opciones, pero no nos compliquemos) invocando al ejecutable del webjob como si estuviese en la carpeta aunque no haya nada en ella. Vamos, que hay que poner el nombre del ejecutable en el archivo y si quieres primero una línea con un «@echo off«, y listo
  4. Si el webjob es de ejecución programada (o si queremos usar otras features como hacer un webjob singleton por ejemplo), meteremos en esa carpeta el archivo settings.job correspondiente.
  5. A continuación hay que decirle a quien corresponda que cuando publique ese proyecto incluya esa carpeta. En el archivo project.json tendremos la propiedad de primer nivel (y si no la creamos) «publishOptions«, y en su interior deberíamos tener (y si no lo creamos) una propiedad de tipo array llamada «include«. Ahí deberemos añadir la ruta de lo creado, por ejemplo «app_data/jobs/**/*.*«. De este modo conseguiremos que cuando se publique se copien esas carpetas con el archivo o los dos archivos que hemos creado.
  6. Por último deberemos decirle que hay que compilar el proyecto del webjob y copiar los archivos a la carpeta de publicación en la ruta adecuada «app_data/jobs/…«. Para esto, en el mismo archivo project.json tienes una propiedad de primer nivel llamada «scripts» y en su interior otra de tipo array que se llama «postpublish» (si no existe alguna, sólo tenéis que escribir). Como el proyecto es de .Net Framework, tendremos que invocar al comando msbuild que nos toque en función del tipo de nuestro proyecto (que espero que sea 2015, no me fastidiéis) la ruta del proyecto y la del destino. En mi caso: «\»%ProgramFiles(x86)%\\MSBuild\\14.0\\Bin\\msbuild.exe\» ..\\ProjectFolder\\ProjectName.csproj /property:OutDir=%publish:OutputPath%\\app_data\\jobs\\Continuous\\WebjobName\\«

Con esto, ya podremos usar la opción de publicar del Visual Studio y que todo funcione. Cuando se publique el proyecto compilará guardando el resultado en la carpeta del webjob en el destino de la publicación.

Como os decía es una chorrada una vez que das con los pasos adecuados.

Lo siguiente es meterlo en el VSTS, y aunque sé que está en preview os recomiendo usar la plantilla de deploy de .Net Core añadiendo los pasos que necesitéis para desplegar en vuestro servidor (por ejemplo un «Azure App Service Deploy» que coja el paquete del destino de la compilación «$(build.artifactstagingdirectory)\**\*.zip«), o si tenéis montado un sistema de release y validaciones que pase por distintos entornos, simplemente la plantilla en cuestión.

Veréis que os pasa en verde, pero que ni webjob ni nada, y si atendéis a los logs de vuestro build, en concreto al del step Publish, veréis que algo no ha ido del todo bien al ejecutar el script de postpublish que introdujimos, y parece que no encuentra muchos archivos. El problema es que en vuestro sistema están todas las librerías necesarias dónde toca porque el plugin de NuGet que tenéis en Visual Studio lo ha hecho sin molestaros.

La solución es tan sencilla como antes de ese paso meter un componente de NuGet install con la opción de restore seleccionada, para que restaure todas las dependencias que tengan los proyectos de .Net Framework de la solución, así como tenéis el Restore de .Net Core.

Con esto ya tendréis todo funcionando, dos tecnologías distintas conviviendo juntas en amor y compañía 😀

Tened en cuenta que en un tiempo indeterminado llamemosle X la información de este post estará obsoleta. En diciembre de 2016 la comunidad abrió un ticket en uno de los githubs de estos proyectos, y unos se lo han pasado a otros cerrando sus tickets, hasta que alguien ha decidido que lo que había que hacer era primero abrir un ticket para pensar lo que hay que hacer… Parece uno de esas chistosas historias paralelas que contaría la voz en off de «La guía del autoestopista galáctico», pero es real, podéis buscarlo vosotros mismos xD. Esperemos que ese X no sea demasiado largo, crucemos los dedos en forma de X.

Cualquier duda o pregunta, o si no se entiende algo, o si algo está mal… escribid un comentario o me contactáis por dónde sea. ¡A cuidarse!